在机器学习与深度学习项目中,训练数据的质量直接决定了模型的上限。数据引入与处理是构建高效、可靠模型的基础环节,涵盖从原始数据采集到最终送入模型训练的全过程。本文将系统介绍训练数据处理的关键步骤,包括数据引入、数据清洗、数据转换、数据划分、数据增强以及数据加载,帮助读者建立完整的训练数据处理流程认知。
一、数据引入:获取原始数据
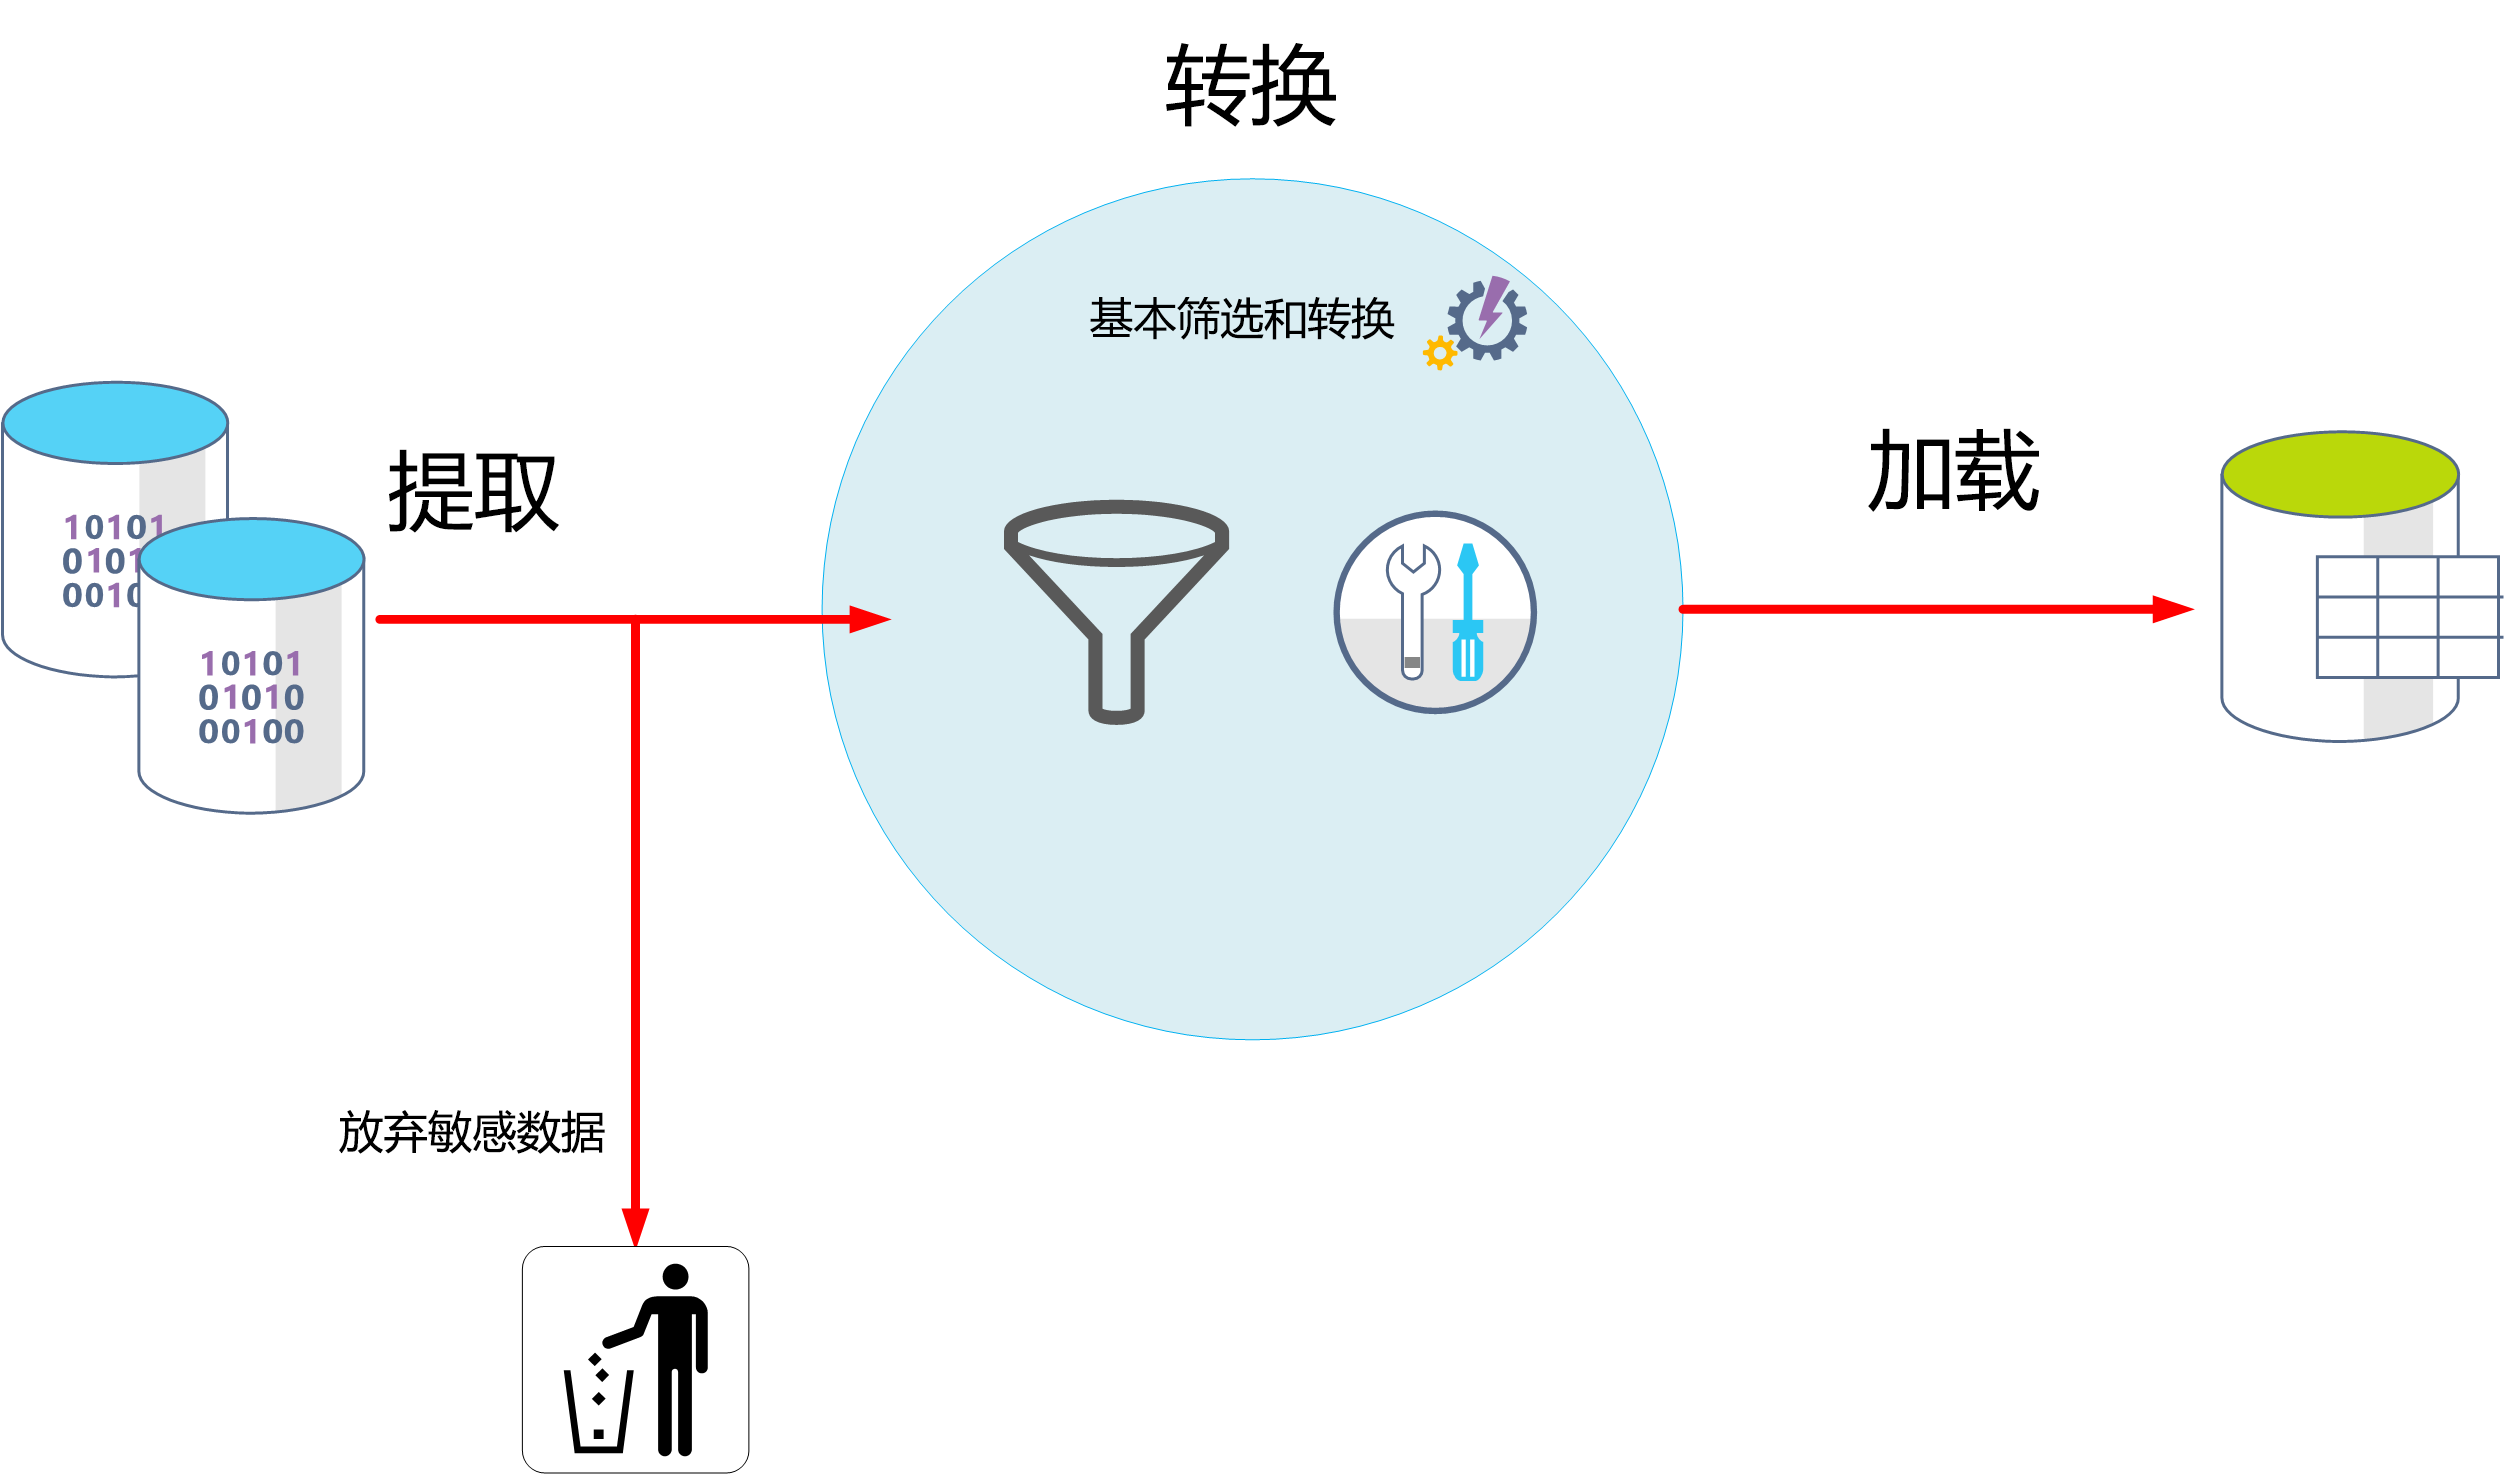
数据引入是训练流程的起点,目的是从各种数据源中收集原始数据。常见的数据源包括:
- 文件系统:CSV、JSON、Parquet、图片、音频等文件。
- 数据库:MySQL、PostgreSQL、MongoDB 等。
- API 接口:通过 HTTP 请求获取结构化或非结构化数据。
- 公开数据集:如 ImageNet、COCO、Kaggle 等平台提供的数据集。
在引入数据时,需要关注数据的规模、格式、存储位置以及访问权限。对于大规模数据,通常采用分布式存储(如 HDFS、S3)和并行读取策略以提高效率。
二、数据清洗:提升数据质量
原始数据往往存在缺失值、噪声、重复项和异常值,需要进行清洗:
- 缺失值处理:删除含有缺失值的样本、填充均值/中位数/众数,或使用模型预测填充。
- 去重:识别并删除重复记录,避免模型过拟合。
- 异常值检测与处理:通过统计方法(如 Z-score、IQR)或可视化发现异常值,并根据业务需求决定删除或替换。
- 噪声处理:使用滤波、平滑或分箱等方法减少随机误差。
清洗后的数据应保持一致性,例如统一单位、格式和编码。
三、数据转换:特征工程与格式化
数据转换是将原始数据转化为模型可用的特征表示:
- 数值型特征:标准化(Z-score Normalization)、归一化(Min-Max Scaling)、离散化等。
- 类别型特征:独热编码(One-Hot Encoding)、标签编码(Label Encoding)、目标编码(Target Encoding)等。
- 文本特征:分词、词干提取、TF-IDF、词嵌入(Word2Vec、BERT)等。
- 图像特征:缩放、裁剪、颜色空间转换等(通常在数据增强中完成)。
- 特征选择:通过方差阈值、卡方检验、递归特征消除等方法降低维度。
需要将数据转换为模型训练所需的格式,如张量(Tensor)或特定框架的数据集对象。
四、数据划分:训练集、验证集与测试集
为了评估模型的泛化能力,需将数据集划分为互不重叠的子集:
- 训练集:用于模型参数学习。
- 验证集:用于超参数调优和模型选择。
- 测试集:用于最终性能评估,仅在最后使用。
常见划分比例有 70/15/15 或 80/10/10。对于小样本数据,可采用交叉验证(如 K 折交叉验证)以充分利用数据。需注意保持各子集的数据分布一致(分层抽样)。
五、数据增强:扩充训练数据
数据增强通过对训练样本进行随机变换来增加数据多样性,提升模型鲁棒性:
- 图像:旋转、翻转、裁剪、颜色抖动、添加噪声等。
- 文本:同义词替换、随机插入/删除、回译等。
- 音频:时间拉伸、音高偏移、添加背景噪声等。
数据增强通常在训练过程中动态进行(在线增强),避免存储膨胀。
六、数据加载:高效 feeding 训练
在训练时,需要高效地将数据送入模型。常用技术包括:
- 批处理:将数据分成小批量(Batch)以减少内存占用并利用并行计算。
- 打乱顺序:每个 epoch 重新打乱数据,避免模型学习到顺序偏差。
- 预取与并行加载:使用多线程/多进程提前加载下一批数据(如 PyTorch 的 DataLoader、TensorFlow 的 tf.data)。
- 缓存:对于小数据集,可一次性加载到内存或显存。
##
训练数据处理是一个迭代且系统的工程,从数据引入到加载,每个环节都需精心设计。高质量的数据处理不仅能提升模型性能,还能减少训练时间和资源消耗。在实际项目中,建议构建可复用的数据处理流水线(Pipeline),并持续监控数据质量,确保模型训练的稳定性和可靠性。